Xây dựng với CometAPICần một API cho nhiều mô hình?Kiểm thử quy trình trong Playground, sau đó tạo API key khi mô hình và chi phí phù hợp với trường hợp sử dụng của bạn.
Mistral 3 là bản phát hành tiêu đề của dòng mô hình cuối năm 2025 từ Mistral AI. Nó mang đến một tập hợp các mô hình nhỏ gọn, nhanh, hướng tới triển khai cục bộ/edge và một mô hình chủ lực thưa (sparse) rất lớn, đẩy giới hạn về quy mô và độ dài ngữ cảnh. Bài viết này giải thích Mistral 3 là gì, được xây dựng ra sao, vì sao bạn có thể muốn chạy nó cục bộ, và ba cách thực tế để chạy trên máy của bạn hoặc máy chủ riêng — từ sự tiện lợi “nhấp-để-chạy” của Ollama, đến triển khai phục vụ GPU production với vLLM/TGI, đến suy luận CPU trên thiết bị nhỏ bằng GGUF + llama.cpp.
Mistral 3 là gì?
Mistral 3 là thế hệ mới nhất của các mô hình open‑weight từ Mistral AI. Dòng sản phẩm bao gồm Mistral Large 3 khổng lồ (một mô hình Mixture‑of‑Experts — MoE — thưa) và một số biến thể edge/“Ministral” (3B, 8B, 14B) được tinh chỉnh cho nhiệm vụ tuân thủ hướng dẫn và đa phương thức (văn bản + thị giác). Mistral định vị bản phát hành để có thể sử dụng rộng rãi: từ suy luận hiệu năng cao trong trung tâm dữ liệu (với các checkpoint tối ưu hóa chuyên biệt) đến sử dụng ở edge và laptop thông qua định dạng lượng tử hóa và các biến thể nhỏ.
Đã được xem xét về độ rõ ràng, ghi nguồn và thuật ngữ API hiện tại.
Kiến trúc Mixture‑of‑Experts (MoE) ở biến thể Large 3 tạo ra số lượng tham số “tổng” rất lớn trong khi chỉ kích hoạt một tập con chuyên gia cho mỗi token — giúp cải thiện hiệu quả ở quy mô lớn.
Một họ mô hình Ministral 3 (3B / 8B / 14B) hướng tới sử dụng ở edge và cục bộ, với các biến thể được tinh chỉnh cho hướng dẫn và đa phương thức.
Checkpoint chính thức và bộ checkpoint tối ưu (NVFP4/FP8) cho các runtime tăng tốc như vLLM và nền tảng NVIDIA.
Đa phương thức + đa ngôn ngữ + ngữ cảnh dài — các bản Ministral và Large nhấn mạnh khả năng hiểu hình ảnh + văn bản và độ phủ ngôn ngữ rộng. Với các ứng dụng trộn hình ảnh + tài liệu dài, điều này rất quan trọng.
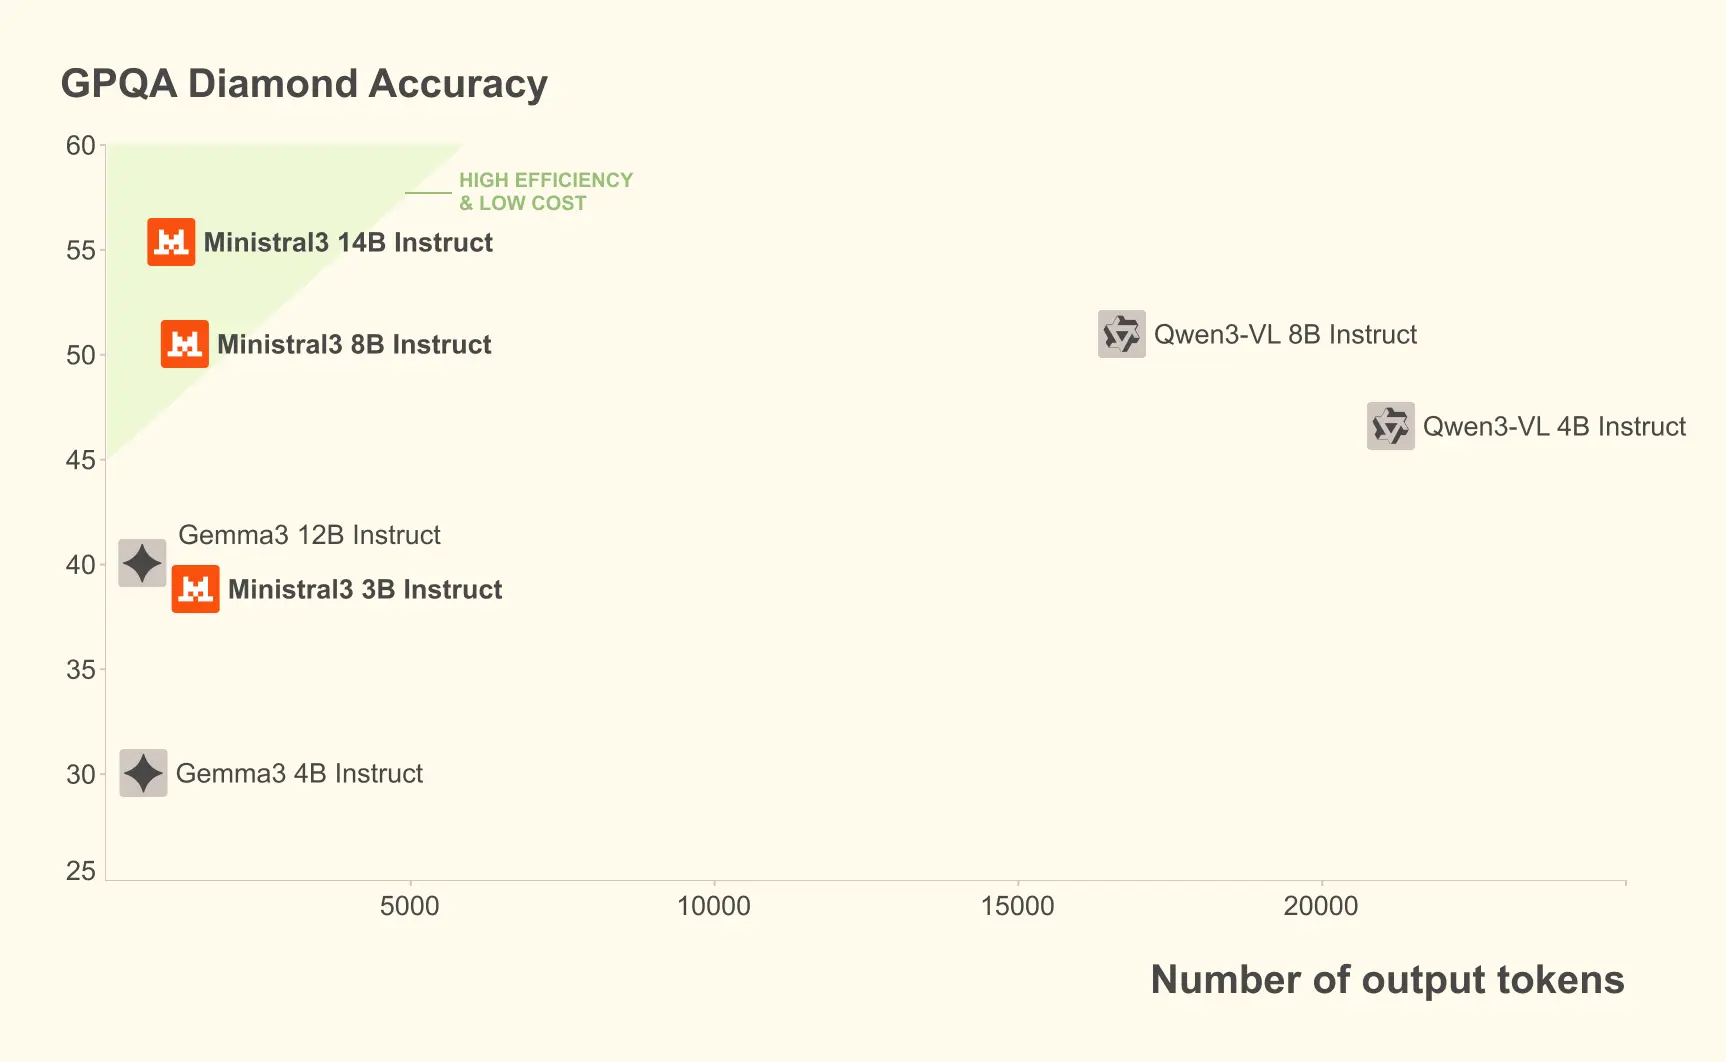
Trên bộ dữ liệu GPQA Diamond (bài kiểm tra lập luận khoa học nghiêm ngặt), nhiều biến thể của Ministral 3 duy trì độ chính xác cao ngay cả khi số lượng token đầu ra tăng lên. Ví dụ, mô hình Ministral 3B Instruct duy trì độ chính xác 35–40% khi xử lý tới 20.000 token, tương đương các mô hình lớn hơn như Gemma 2 9B, trong khi dùng ít tài nguyên hơn.
Kiến trúc của Mistral 3 là gì?
Mistral 3 là một họ mô hình chứ không phải một kiến trúc đơn lẻ, nhưng có hai mẫu kiến trúc bạn cần hiểu:
Các mô hình nhỏ dạng dense (Ministral 3)
Ngăn xếp transformer tiêu chuẩn, tối ưu cho hiệu quả và suy luận trên edge.
Cung cấp nhiều kích cỡ (3B/8B/14B) và các biến thể fine‑tune khác nhau: base, instruct và reasoning; nhiều biến thể hỗ trợ đa phương thức bản địa (thị giác + văn bản) và vận hành ngữ cảnh dài. Các mô hình Ministral được phát hành với trọng số FP8 tối ưu cho sự gọn nhẹ ở một số bản phân phối.
Mixture‑of‑Experts thưa (Mistral Large 3)
Kiến trúc MoE: mô hình có nhiều chuyên gia (tổng số tham số khổng lồ), nhưng chỉ một tập chuyên gia được bộ định tuyến chọn để đánh giá trên mỗi token — mang lại đánh đổi tốt hơn giữa quy mô và tài nguyên tính toán.
Mistral Large 3 nêu ~675B tham số tổng với ~41B tham số hoạt động trong quá trình suy luận, phản ánh thiết kế MoE này. Mô hình được huấn luyện trên phần cứng NVIDIA hiện đại và tối ưu cho thực thi hiệu quả với độ chính xác thấp (NVFP4/TensorRT/tối ưu large‑kernel).
Các tính năng kỹ thuật quan trọng khi chạy cục bộ:
Ngữ cảnh dài: một số biến thể Mistral 3 hỗ trợ ngữ cảnh rất dài (tài liệu vLLM và Mistral đề cập cửa sổ ngữ cảnh khổng lồ cho một số biến thể; ví dụ, 256k ở một số bản Ministral). Điều đó ảnh hưởng tới bộ nhớ và cách phục vụ.
Định dạng trọng số & lượng tử hóa: Mistral cung cấp trọng số ở các định dạng nén/tối ưu (FP8, NVFP4) và làm việc với các chuỗi công cụ lượng tử hóa hiện đại (BitsAndBytes, GPTQ, toolchain của nhà cung cấp) để suy luận cục bộ thực tiễn.
Vì sao bạn nên chạy Mistral 3 cục bộ?
Chạy LLM cục bộ không còn là sở thích ngách — đó là lựa chọn thực tế cho các nhóm và cá nhân quan tâm tới:
Quyền riêng tư dữ liệu và tuân thủ. Lưu trữ nội bộ giữ dữ liệu nhạy cảm trong hạ tầng của bạn (quan trọng với tài chính, y tế, pháp lý). Reuters đưa tin khách hàng nổi tiếng chọn tự lưu trữ các mô hình Mistral.
Độ trễ và kiểm soát chi phí. Với SLO độ trễ chặt và chi phí dự đoán được, suy luận cục bộ hoặc trên cụm riêng có thể vượt API đám mây về chi phí bất ngờ. Các biến thể Ministral nhỏ và định dạng lượng tử hóa khiến điều này khả thi.
Tùy biến và fine‑tune. Khi bạn cần hành vi tùy chỉnh, function calling hoặc phương thức mới, kiểm soát cục bộ cho phép fine‑tune và xử lý dữ liệu tùy biến. Tích hợp với Hugging Face và vLLM khiến việc này ngày càng “một chạm”.
Nếu những lý do đó phù hợp với ưu tiên của bạn — riêng tư, kiểm soát, chi phí dự đoán được hoặc nghiên cứu — thì triển khai cục bộ rất đáng cân nhắc.
Bạn có thể chạy Mistral 3 cục bộ thế nào (ba phương pháp thực tiễn)?
Có nhiều cách chạy Mistral 3 cục bộ. Tôi sẽ đề cập ba cách bao quát các kịch bản người dùng phổ biến nhất:
Ollama (máy tính để bàn/máy chủ cục bộ zero‑config, dễ nhất với nhiều người dùng)
Hugging Face Transformers + PyTorch / vLLM (toàn quyền kiểm soát, cụm GPU)
llama.cpp / ggml / suy luận CPU định lượng GGUF (nhẹ, chạy trên laptop/CPU)
Với mỗi phương pháp, tôi sẽ nêu khi nào nên dùng, điều kiện tiên quyết, các bước theo trình tự và ví dụ mã nhỏ.
1) Chạy Mistral 3 với Ollama (nhanh nhất)?
Khi nào dùng: bạn muốn trải nghiệm cục bộ không ma sát (macOS/Linux/Windows), CLI hoặc GUI thân thiện và tự động tải xuống/các artifact đã lượng tử hóa khi có. Ollama có mục mô hình cho Ministral 3 và các thành viên khác của họ Mistral.
Điều kiện tiên quyết
Đã cài Ollama (làm theo trình cài trên ollama.com). Thư viện Ollama nêu phiên bản tối thiểu cụ thể cho một số bản Ministral.
Đủ dung lượng đĩa để lưu artifact của mô hình (kích thước khác nhau — bản Ministral 3B lượng tử có thể vài GB; các biến thể BF16 lớn hơn là vài chục GB).
Các bước (ví dụ)
Cài Ollama (ví dụ macOS — thay đổi theo nền tảng):
# macOS (Homebrew) example — see ollama.com for platform-specific installersbrew install ollama
Chạy một mô hình Ministral:
# Pull and run the model interactivelyollama run ministral-3
Phục vụ cục bộ (API) và gọi từ mã:
# Run Ollama server (default port shown in docs)ollama serve# Then curl against it (example)curl -s -X POST "http://localhost:11434/api/v1/generate" \ -H "Content-Type: application/json" \ -d '{"model":"ministral-3","prompt":"Summarize Mistral 3 in one sentence."}'
Ghi chú & mẹo
Ollama xử lý tải xuống mô hình và (khi có) các biến thể lượng tử cục bộ — rất tiện để thử mô hình nhanh.
Nếu bạn định dùng mô hình trong production với nhiều yêu cầu đồng thời, Ollama rất tốt để dựng mẫu, nhưng hãy đánh giá khả năng mở rộng và điều phối tài nguyên cho tải ổn định.
2) Chạy Mistral 3 với Hugging Face Transformers (GPU / tích hợp vLLM)?
Khi nào dùng: bạn cần kiểm soát theo lập trình để nghiên cứu hoặc production, muốn fine‑tune, hoặc dùng các ngăn suy luận tăng tốc như vLLM trên cụm GPU. Hugging Face cung cấp hỗ trợ Transformers và Mistral phát hành checkpoint tối ưu cho vLLM/NVIDIA.
Điều kiện tiên quyết
GPU có đủ bộ nhớ (tùy mô hình và độ chính xác). Ministral 3 cỡ nhỏ (3B/8B) có thể chạy trên một GPU tầm trung khi đã lượng tử; các biến thể lớn cần nhiều H100/A100 hoặc checkpoint NVFP4 tối ưu cho vLLM. Tài liệu NVIDIA và Mistral khuyến nghị cấu hình node cụ thể cho các mô hình lớn.
Ví dụ Python — pipeline Hugging Face cơ bản (biến thể instruct 3B, GPU):
# Example: CPU/GPU inference with transformers pipeline# Assumes you have CUDA and a compatible PyTorch build.import torchfrom transformers import pipelinemodel_name = "mistralai/Ministral-3-3B-Instruct-2512-BF16" # example HF model idgenerator = pipeline( "text-generation", model=model_name, device_map="auto", torch_dtype=torch.bfloat16, # use bfloat16 if your hardware supports it)prompt = "Explain how attention helps transformers, in 3 sentences."out = generator(prompt, max_new_tokens=120, do_sample=False)print(out[0]["generated_text"])
Dùng vLLM cho suy luận GPU production
vLLM được thiết kế để phục vụ các mô hình lớn hiệu quả, hỗ trợ họ Mistral 3, và Mistral công bố checkpoint tối ưu cho phần cứng vLLM/NVIDIA (NVFP4/FP8) để giảm bộ nhớ và tăng tốc. Khởi chạy server vLLM cho bạn một endpoint suy luận độ trễ thấp, gom lô. Xem công thức vLLM và hướng dẫn Mistral để biết đường dẫn mô hình và cờ khuyến nghị.
Ghi chú & mẹo
Với production, nên dùng checkpoint tối ưu (NVFP4/FP8) và chạy trên GPU khuyến nghị (ví dụ, H100/A100) hoặc dùng lớp điều phối hỗ trợ song song hóa theo tensor/mô hình. Mistral và NVIDIA có tài liệu và bài viết về runtime tối ưu.
Luôn pin chính xác checkpoint mô hình trên đĩa (hoặc snapshot HF có thể tái lập) để có kết quả tái lập và tránh cập nhật mô hình ngầm.
3) Chạy Mistral 3 trên CPU với llama.cpp / mô hình GGUF lượng tử?
Khi nào dùng: bạn cần suy luận cục bộ, ngoại tuyến trên CPU (ví dụ, laptop của nhà phát triển, môi trường cách ly mạng) và sẵn sàng đánh đổi một phần độ chính xác để lấy tốc độ chạy và hiệu quả bộ nhớ. Phương pháp này dùng ggml/llama.cpp và trọng số GGUF lượng tử (q4/q5/v.v.).
Điều kiện tiên quyết
Bản GGUF lượng tử của một mô hình Ministral (nhiều thành viên cộng đồng công bố GGUF lượng tử trên Hugging Face hoặc chuyển trọng số BF16 sang GGUF cục bộ). Tìm Ministral-3-3B-Instruct các biến thể GGUF.
Đã biên dịch binary llama.cpp (theo README của dự án).
Lượng tử (nếu bạn có trọng số gốc) — ví dụ (khái niệm)
# Example: quantize from an FP16/BF16 model to a GGUF q4_K_M (syntax depends on llama.cpp version)./quantize /path/to/original/model.bin /path/to/out.gguf q4_k_m
Chạy một GGUF với llama.cpp
# run interactive inference with a quantized GGUF model./main -m /path/to/ministral-3-3b-instruct.gguf -t 8 -c 2048 --interactive# -t sets threads, -c sets context (tokens) if supported
Ví dụ client Python (server llama.cpp cục bộ hoặc subprocess)
Bạn có thể spawn llama.cpp như một subprocess và cung cấp prompt, hoặc dùng wrapper client nhỏ. Nhiều dự án cộng đồng cung cấp server HTTP đơn giản quanh llama.cpp để tích hợp ứng dụng cục bộ.
Ghi chú & đánh đổi
Lượng tử hóa giảm VRAM và cho phép suy luận trên CPU nhưng có thể làm giảm chất lượng (nhẹ đến trung bình, tùy định dạng lượng tử). Các định dạng như q4_K_M hoặc q5 là thỏa hiệp phổ biến cho CPU. Nhiều bài viết kỹ thuật giải thích chi tiết các loại Q4/Q5 và chuyển đổi GGUF.
Với khối lượng nhỏ đến trung bình, GGUF + llama.cpp thường là cách rẻ nhất và di động nhất để chạy LLM cục bộ.
Cần lưu ý gì về phần cứng và bộ nhớ?
Hướng dẫn ngắn, thực tiễn:
Mô hình 3B: thường có thể lượng tử và chạy trên CPU laptop khá hoặc một GPU đơn với 8–16 GB VRAM (tùy độ chính xác/lượng tử). Biến thể GGUF q4 có thể chạy trên nhiều CPU hiện đại.
Ministral 8B và 14B: thường cần GPU tầm trung (ví dụ, 24–80 GB tùy độ chính xác và bộ nhớ cache kích hoạt) hoặc lượng tử trên nhiều thiết bị.
Mistral Large 3 (675B tổng, 41B hoạt động): dành cho triển khai trung tâm dữ liệu và thường chạy tốt nhất với node đa GPU (ví dụ, 8×A100 hoặc H100) và định dạng chuyên biệt (NVFP4/FP8) cho vLLM. Mistral đã công bố checkpoint tối ưu để giúp các triển khai như vậy khả thi.
Nếu ưu tiên của bạn là dùng trên laptop cục bộ, hãy nhắm tới Ministral 3B lượng tử GGUF + llama.cpp. Nếu ưu tiên là thông lượng production, hãy xem vLLM + checkpoint NVFP4 trên GPU. Nếu bạn muốn dễ thử nghiệm, Ollama là cách bắt đầu nhanh nhất.
Bạn nên chọn lượng tử và độ chính xác thế nào?
Lượng tử là đánh đổi: bộ nhớ và tốc độ so với chất lượng mô hình thô. Lựa chọn phổ biến:
q4_0 / q4_1 / q4_K_M: các tùy chọn 4‑bit phổ biến dùng cho suy luận CPU; q4_K_M (biến thể k‑means) thường cân bằng tốt chất lượng/hiệu năng.
q5 / q8 / biến thể imatrix: các định dạng trung gian có thể giữ nhiều độ trung thực hơn với chi phí kích cỡ.
FP16 / BF16 / FP8 / NVFP4: độ chính xác trên GPU — BF16 và FP16 phổ biến cho huấn luyện/suy luận trên GPU hiện đại; FP8/NVFP4 là định dạng mới nổi giúp tiết kiệm bộ nhớ cho mô hình rất lớn và được hỗ trợ bởi runtime tối ưu và checkpoint của Mistral.
Quy tắc kinh nghiệm: cho chạy CPU cục bộ, chọn q4_K_M hoặc tương tự; cho suy luận GPU với độ trung thực cao, dùng BF16/FP16 hoặc FP8/NVFP4 của nhà cung cấp khi runtime hỗ trợ.
Kết luận — bạn có nên chạy Mistral 3 cục bộ?
Nếu bạn cần riêng tư, độ trễ thấp hoặc tùy biến, có: họ Mistral 3 cho bạn một bảng màu rộng — mô hình nhỏ cho CPU edge, mô hình cỡ vừa cho một GPU hoặc cụm khiêm tốn, và hương vị MoE lớn cho quy mô trung tâm dữ liệu — và hệ sinh thái (Ollama, Hugging Face, vLLM, llama.cpp) đã hỗ trợ các mẫu triển khai cục bộ và riêng tư thực tiễn. Mistral cũng làm việc với NVIDIA và vLLM để cung cấp checkpoint tối ưu cho thông lượng cao và dấu chân bộ nhớ giảm, khiến tự lưu trữ trong production thực tế hơn trước.
Để bắt đầu, hãy khám phá khả năng của nhiều mô hình hơn (chẳng hạn như Gemini 3 Pro) trong Playground và tham khảo hướng dẫn API để biết hướng dẫn chi tiết. Trước khi truy cập, vui lòng đảm bảo bạn đã đăng nhập CometAPI và lấy khóa API. CometAPI cung cấp mức giá thấp hơn nhiều so với giá chính thức để giúp bạn tích hợp.