Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Hong Kong EFOXTech Limited
RM A133 OF UNIT 1, 15/F, BLOCK A WAH SANG BUILDING NOS.14-18 WONG CHUK YEUNG STREET SHA TIN, Hong Kong
guide / CometAPIリサーチ
Mistral 3 をローカルで実行する方法 Mistral 3 は、Mistral AI の 2025 年後半モデルファミリーの目玉リリースです。ローカル/エッジ展開向けのコンパクトで高速なモデル群と、スパースな超大型フラッグシップを組み合わせ、最先端のスケールとコンテキスト長を押し広げます。本記事では、Mistral 3 の概要、アーキテクチャ、ローカル実行の利点、そしてあなたのマシンやプライベートサーバーで動かすための実用的な 3 つの方法(Ollama の“クリックして実行”な手軽さから、vLLM/TGI による本番 GPU サービング、GGUF + llama.cpp を用いた小型デバイスでの CPU 推論まで)を解説します。 What is Mistral 3? M
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)Mistral 3 は、Mistral AI の 2025 年後半モデルファミリーの目玉リリースです。ローカル/エッジ展開向けのコンパクトで高速なモデル群と、スパースな超大型フラッグシップを組み合わせ、最先端のスケールとコンテキスト長を押し広げます。本記事では、Mistral 3 の概要、アーキテクチャ、ローカル実行の利点、そしてあなたのマシンやプライベートサーバーで動かすための実用的な 3 つの方法(Ollama の“クリックして実行”な手軽さから、vLLM/TGI による本番 GPU サービング、GGUF + llama.cpp を用いた小型デバイスでの CPU 推論まで)を解説します。
What is Mistral 3?
Mistral 3 は、Mistral AI による最新世代のオープンウェイトモデルです。このファミリーには、巨大な Mistral Large 3(スパースな Mixture-of-Experts — MoE — モデル)に加え、エッジ/“ministral” 系(3B、8B、14B)で、命令追従とマルチモーダル(テキスト+ビジョン)タスクに調整された複数のバリアントが含まれます。Mistral はこのリリースを幅広い用途に向けて位置づけています。すなわち、高性能なデータセンター推論(特化した最適化チェックポイント)から、量子化形式と小型バリアントによるエッジやノート PC での利用までカバーします。
Key practical properties :
大規模バリアントである Mixture-of-Experts(MoE) アーキテクチャにより、“総”パラメータ数は非常に大きい一方で、トークンごとにアクティブ化されるエキスパートは一部に限られるため、スケール時の効率が向上します。
エッジやローカル利用を想定した
明確性、出典の帰属、最新のAPI用語について確認済みです。
Ministral 3
公式チェックポイントに加え、vLLM や NVIDIA プラットフォームのような加速ランタイム向けの最適化チェックポイント(NVFP4/FP8)を提供。
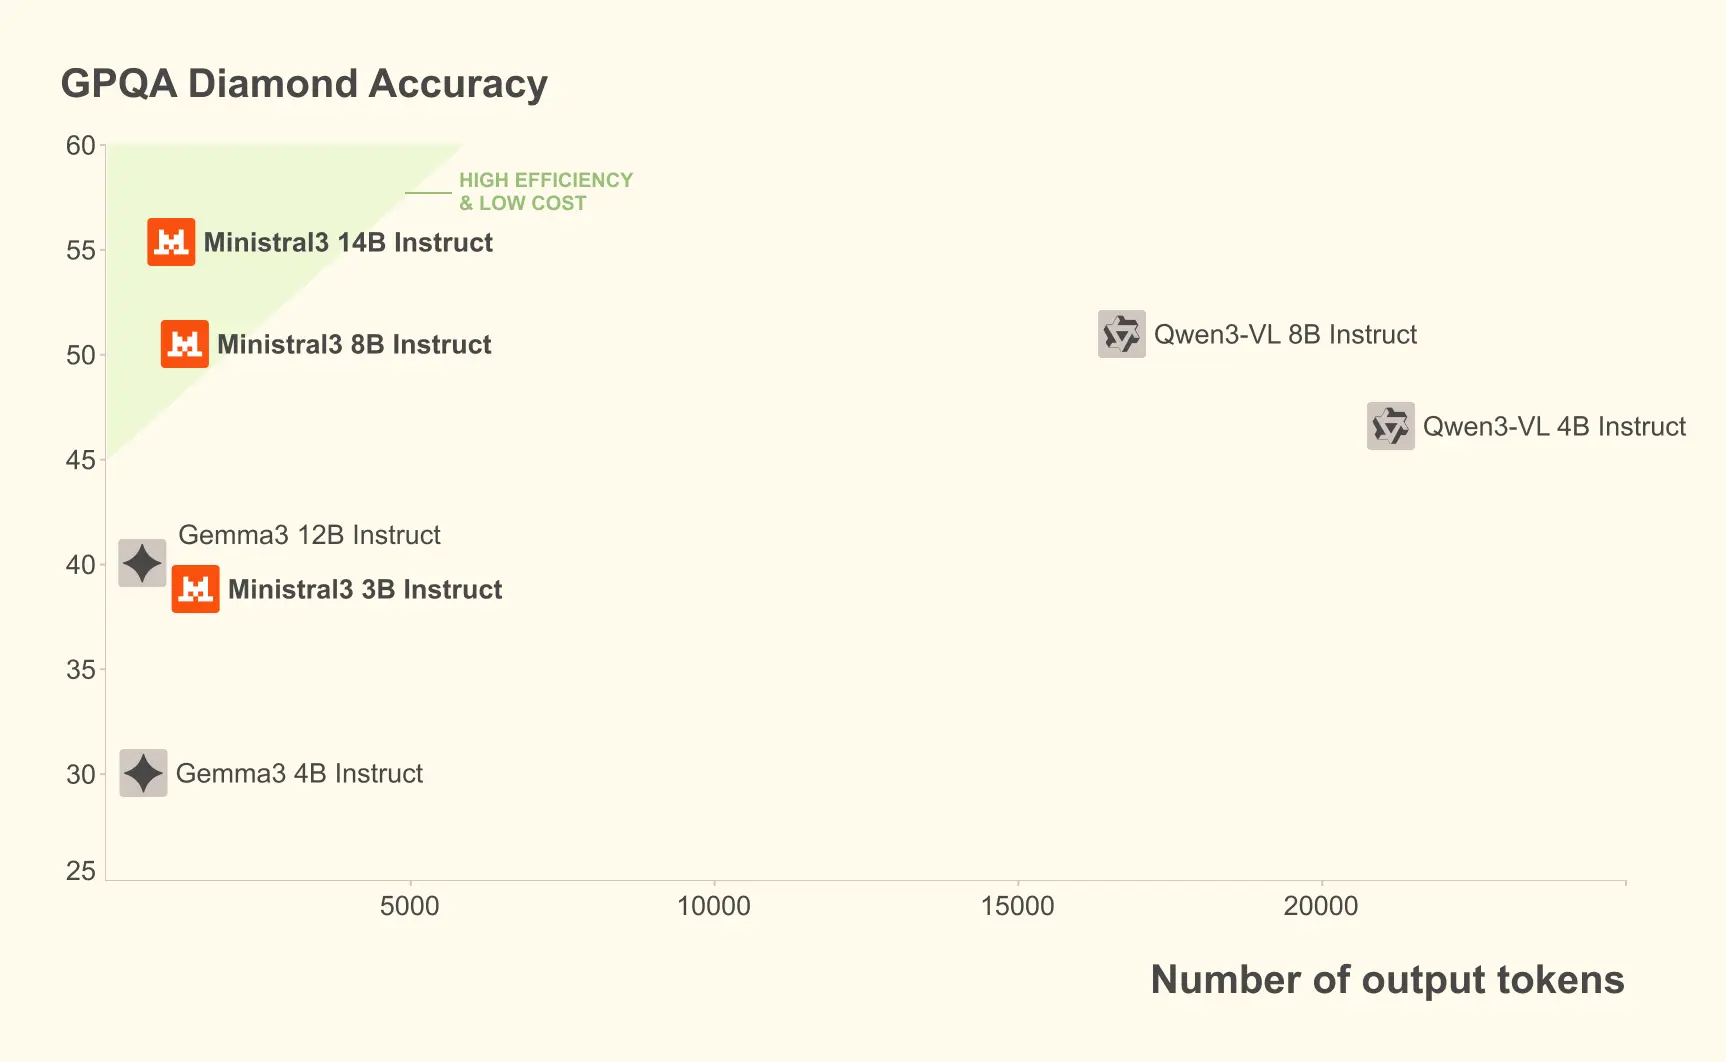
マルチモーダル + 多言語 + ロングコンテキスト — Ministral 系および Large 系の各バリアントは、画像+テキスト理解と広い言語カバレッジを重視しています。画像と長文ドキュメントを組み合わせるアプリケーションでは重要です。GPQA Diamond データセット(厳密な科学的推論テスト)では、Miniral 3 の各バリアントは出力トークン数が増えても高い精度を維持します。例えば、Miniral 3B Instruct モデルは最大 20,000 トークンを扱う場合でも 35–40% の精度を維持し、Gemma 2 9B のようなより大きなモデルに匹敵しつつ、より少ないリソースで動作します。
What is the architecture of Mistral 3? Mistral 3 は単一のアーキテクチャではなくファミリーですが、理解すべきアーキテクチャパターンは 2 つあります。
Dense small models (Ministral 3)
標準的な Transformer スタックを採用し、効率とエッジ推論に最適化。
複数サイズ(3B/8B/14B)と多様なファインチューニング済みバリアント(base、instruct、reasoning)を提供。多くのバリアントがネイティブのマルチモーダル(Vision + Text)対応とロングコンテキスト動作を備えます。Minstral モデルは、配布によってはコンパクト性のために最適化された FP8 ウェイトで提供されます。
Sparse Mixture-of-Experts (Mistral Large 3)
MoE アーキテクチャ:多数のエキスパート(総パラメータ数は非常に大きい)を持ち、トークンごとにルーティングで選ばれた一部のみを評価します。これにより、計算量に対するスケールのトレードオフが改善されます。
Mistral Large 3 は、推論時にアクティブなパラメータがおよそ 41B、総パラメータがおよそ 675B とされ、MoE 設計を反映しています。モデルは最新の NVIDIA ハードウェアで学習され、低精度(NVFP4/TensorRT/大カーネル最適化)での効率的な実行に最適化されています。
ロングコンテキスト :一部の Mistral 3 バリアントは非常に長いコンテキストをサポートします(vLLM のドキュメントや Mistral のドキュメントでは、一部の Ministral バリアントで 256k のコンテキストウィンドウが言及されています)。これはメモリやサービングのパターンに影響します。 ウェイト形式と量子化 :Mistral は圧縮/最適化された形式(FP8、NVFP4)でウェイトを提供し、実用的なローカル推論のために最新の量子化ツールチェーン(BitsAndBytes、GPTQ、ベンダーツールチェーン)と連携します。
Why would you run Mistral 3 locally? LLM のローカル実行は、もはやニッチな趣味ではありません。以下を重視するチームや個人にとって実用的な選択肢です。
データプライバシーとコンプライアンス。 ローカルホスティングにより、機密入力を自社インフラ内部に留められます(金融、医療、法務で重要)。Reuters は、著名な顧客が Mistral モデルのセルフホストを選択したと報じています。 レイテンシとコストの管理。 厳しいレイテンシ SLO と予測可能なコストが必要な場合、ローカルやプライベートクラスターでの推論は、クラウド API の予期せぬ高額請求を上回ることがあります。小型の Ministral バリアントや量子化形式により、これが現実的になります。カスタマイズと微調整。 独自の挙動、関数呼び出し、新しいモダリティが必要な場合、ローカル制御により、独自の微調整とデータ処理が可能になります。Hugging Face や vLLM の統合により、より簡単に始められます。 これらの理由(プライバシー、制御、コストの予見性、研究)が優先事項に合致するなら、ローカル展開を検討する価値があります。
How can you run Mistral 3 locally (three practical methods)? Mistral 3 をローカルで動かす方法は多数あります。ここでは、最も一般的なユーザーシナリオをカバーする 3 つのアプローチを紹介します。
Ollama(ゼロ設定のデスクトップ/ローカルサーバー。多くのユーザーにとって最も簡単) Hugging Face Transformers + PyTorch / vLLM(完全制御、GPU クラスタ) llama.cpp / ggml / GGUF 量子化による CPU 推論(軽量、ノート PC/CPU で動作)
1) How can you run Mistral 3 with Ollama (quickest path)? こんなときに最適: ローカル(macOS/Linux/Windows)で摩擦のない体験、使いやすい CLI/GUI、(利用可能な場合の)自動ダウンロード/量子化アーティファクトを求めている。Ollama には Ministral 3 やその他の Mistral ファミリーのモデルエントリがあります。
Prerequisites
Ollama のインストール(ollama.com のインストーラに従ってください)。特定の Ministral リリースには、Ollama ライブラリで示される最小バージョン要件があります。
モデルアーティファクトを保存するための十分なディスク容量(モデルサイズはさまざま — Ministral 3B の量子化版は数 GB、より大きい BF16 バリアントは数十 GB に及ぶことがあります)。
Steps (example)
Ollama をインストール(macOS 例 — OS ごとの手順に置き換えてください):
# macOS (Homebrew) example — see ollama.com for platform-specific installersbrew install ollama
# Pull and run the model interactivelyollama run ministral-3
ローカルでサーブ(API)し、コードから呼び出し:
# Run Ollama server (default port shown in docs)ollama serve# Then curl against it (example)curl -s -X POST "http://localhost:11434/api/v1/generate" \ -H "Content-Type: application/json" \ -d '{"model":"ministral-3","prompt":"Summarize Mistral 3 in one sentence."}'
Ollama はモデルのダウンロードと(利用可能な場合の)ローカル量子化バリアントを処理します。すぐにモデルを試せるのが大変便利です。
多数の同時リクエストを伴う本番利用を計画している場合、Ollama はプロトタイピングには最適ですが、定常負荷に対するスケーリングやリソースオーケストレーションの評価を行ってください。
こんなときに最適: 研究や本番に向けたプログラム制御が必要、微調整を行いたい、または vLLM のような高速推論スタックを GPU クラスターで使いたい。Hugging Face は Transformers サポートを提供し、Mistral は vLLM/NVIDIA 向けの最適化チェックポイントを提供しています。
Prerequisites
十分なメモリを持つ GPU(モデルと精度によって異なります)。Ministral 3 の小型(3B/8B)は量子化すればミドルレンジ GPU 1 枚で動作可能な場合があります。より大きなバリアントには複数枚の H100/A100 や vLLM 向けの NVFP4 最適化チェックポイントが必要です。NVIDIA と Mistral のドキュメントでは Large モデル向けの推奨ノードサイズが示されています。
Python、PyTorch、transformers、accelerate(または vLLM サーバーを使う場合は vLLM)。
Python example — basic Hugging Face pipeline (3B instruct variant, GPU): # Example: CPU/GPU inference with transformers pipeline# Assumes you have CUDA and a compatible PyTorch build.import torchfrom transformers import pipelinemodel_name = "mistralai/Ministral-3-3B-Instruct-2512-BF16" # example HF model idgenerator = pipeline( "text-generation", model=model_name, device_map="auto", torch_dtype=torch.bfloat16, # use bfloat16 if your hardware supports it)prompt = "Explain how attention helps transformers, in 3 sentences."out = generator(prompt, max_new_tokens=120, do_sample=False)print(out[0]["generated_text"])
Using vLLM for production GPU inference vLLM は大規模モデルを効率的にサーブするために設計されており、Mistral 3 ファミリーをサポートします。Mistral はメモリフットプリントを削減して高速化する vLLM/NVIDIA ハードウェア向け(NVFP4/FP8)の最適化チェックポイントを公開しています。vLLM サーバーを起動すれば、低レイテンシでバッチ対応の推論エンドポイントを提供できます。モデルパスや推奨フラグについては vLLM のレシピと Mistral のガイダンスを参照してください。
Notes & tips
本番では最適化チェックポイント(NVFP4/FP8)を優先し、推奨 GPU(例:H100/A100)で実行するか、テンソル/モデル並列をサポートするオーケストレーション層を使用してください。Mistral と NVIDIA は最適化ランタイムに関するドキュメントやブログ投稿を提供しています。
再現性のため、ディスク上のモデルチェックポイント(または再現可能な HF スナップショット)を必ず固定し、サイレントなモデル更新を避けてください。
3) How can you run Mistral 3 on CPU with llama.cpp / GGUF quantized models? こんなときに最適: CPU 上でローカル・オフライン推論(例:開発者のノート PC、厳密に隔離された環境)が必要で、精度をある程度犠牲にしても実行速度とメモリ効率を優先したい場合。この方法では ggml/llama.cpp と GGUF 量子化ウェイト(q4/q5/など)を用います。
Prerequisites
Ministral モデルの GGUF 量子化ビルド(コミュニティが Hugging Face 上で多くの GGUF 量子化版を公開。あるいは BF16 ウェイトからローカルで GGUF に変換)。Ministral-3-3B-Instruct の GGUF バリアントを検索してください。
コンパイル済みの llama.cpp バイナリ(プロジェクトの README に従ってください)。
Quantize (if you have original weights) — example (conceptual) # Example: quantize from an FP16/BF16 model to a GGUF q4_K_M (syntax depends on llama.cpp version)./quantize /path/to/original/model.bin /path/to/out.gguf q4_k_m
Run a GGUF with llama.cpp # run interactive inference with a quantized GGUF model./main -m /path/to/ministral-3-3b-instruct.gguf -t 8 -c 2048 --interactive# -t sets threads, -c sets context (tokens) if supported
Python client example (local llama.cpp server or subprocess) llama.cpp をサブプロセスとして起動してプロンプトを与えるか、小さなラッパークライアントを使用できます。コミュニティの多くのプロジェクトが、ローカルアプリ統合向けに llama.cpp のシンプルな HTTP サーバーラッパーを提供しています。
Notes & tradeoffs
量子化は VRAM を削減し、CPU 推論を可能にしますが、精度が低下する場合があります(量子化形式によって軽度〜中程度)。q4_K_M や q5 系は、CPU 用として品質/性能の妥協点としてよく使われます。Q4/Q5 の種類や GGUF 変換の詳細は、日本語や技術系の投稿で広く解説されています。
小〜中規模のワークロードでは、GGUF + llama.cpp はローカル LLM を動かすための最も安価で可搬性の高い方法であることが多いです。
What hardware and memory considerations matter?
3B モデル: 量子化すれば、十分な性能のノート PC の CPU や 1 枚の GPU(8–16 GB VRAM、精度/量子化に依存)で動作可能な場合があります。GGUF の q4 系は多くの最新 CPU で動作します。 8B と 14B の Ministral: 一般にミドルレンジの GPU(例:24–80 GB、精度やアクティベーションキャッシュに依存)や、複数デバイスにまたがる量子化が必要になります。 Mistral Large 3(総 675B、アクティブ 41B): データセンター展開を想定しており、通常はマルチ GPU ノード(例:8×A100 または H100)と、vLLM 向けの NVFP4 などの特化形式で最も良好に動作します。Mistral はこのような展開を現実的にするための最適化チェックポイントを明示的に公開しています。 優先事項がローカルなノート PC 利用 なら、Ministral 3B の量子化 GGUF + llama.cpp を目指しましょう。本番スループット が重要なら、GPU 上での vLLM + NVFP4 チェックポイントを検討してください。実験のしやすさ なら、Ollama が最速の入り口です。
How should you choose quantization and precision? 量子化は、メモリと速度と引き換えに生のモデル品質をトレードする行為です。一般的な選択肢:
q4_0 / q4_1 / q4_K_M: CPU 推論で使われる代表的な 4-bit。q4_K_M(k-means 系)は品質/性能バランスが良いことが多い。 q5 / q8 / imatrix 系: サイズと引き換えに忠実度をより保ちたい場合の中間的な選択肢。 FP16 / BF16 / FP8 / NVFP4: GPU 向けの精度。BF16 と FP16 は現行 GPU での学習/推論で一般的。FP8 / NVFP4 は非常に大きなモデルのメモリ節約に有望で、最適化ランタイムや Mistral のチェックポイントでサポートされています。 目安: ローカル CPU 実行には q4_K_M などを、GPU で高忠実度の推論を行う場合は BF16/FP16、またはランタイムがサポートするベンダー固有の FP8/NVFP4 を選びましょう。
Conclusion — should you run Mistral 3 locally? プライバシー、低レイテンシ、カスタマイズ を必要とするなら、答えはイエスです。Mistral 3 ファミリーは、エッジ CPU 向けの小型モデル、単一 GPU や小規模クラスタ向けの中型モデル、データセンタースケール向けの大規模 MoE と、幅広い選択肢を提供します。またエコシステム(Ollama、Hugging Face、vLLM、llama.cpp)が、実用的なローカル/プライベート展開パターンをすでにサポートしています。さらに Mistral は NVIDIA と vLLM と協力し、高スループットとメモリ削減に向けた最適化チェックポイントを提供しており、これまでより現実的にプロダクションのセルフホスティングを実現できます。