Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
Mistral 3 è il rilascio di punta della famiglia di modelli di fine 2025 di Mistral AI. Porta una combinazione di modelli compatti e veloci pensati per il deployment locale/edge e una grande ammiraglia sparsa che spinge lo stato dell’arte in termini di scala e lunghezza del contesto. Questo articolo spiega cos’è Mistral 3, come è costruito, perché potresti volerlo eseguire in locale e tre modi pratici per farlo girare sul tuo computer o server privato — dalla comodità “click-to-run” di Ollama al serving su GPU in produzione con vLLM/TGI, fino all’inferenza su CPU per dispositivi molto piccoli usando GGUF + llama.cpp.
Che cos’è Mistral 3?
Mistral 3 è l’ultima generazione di modelli a pesi aperti di Mistral AI. La famiglia include sia un enorme Mistral Large 3 (un modello sparso Mixture-of-Experts — MoE) sia diverse varianti edge/“Ministral” (3B, 8B, 14B) ottimizzate per il seguito di istruzioni e compiti multimodali (testo+visione). Mistral ha posizionato il rilascio per essere ampiamente utilizzabile: dall’inferenza ad alte prestazioni in data center (con checkpoint specializzati e ottimizzati) fino all’uso su edge e laptop tramite formati quantizzati e varianti più piccole.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Un’architettura Mixture-of-Experts (MoE) nella variante Large 3 che offre un numero “totale” di parametri molto elevato attivando però solo un sottoinsieme di esperti per token — questo migliora l’efficienza su larga scala.
Una famiglia di modelli Ministral 3 (3B / 8B / 14B) pensati per l’edge e l’uso locale, con varianti instruction-tuned e multimodali.
Checkpoint ufficiali e una serie di checkpoint ottimizzati (NVFP4/FP8) per runtime accelerati come vLLM e piattaforme NVIDIA.
Multimodale + multilingue + contesto lungo — le varianti Ministral e Large enfatizzano la comprensione immagine+testo e un’ampia copertura linguistica. Per applicazioni che combinano immagini + documenti lunghi, questo è importante.
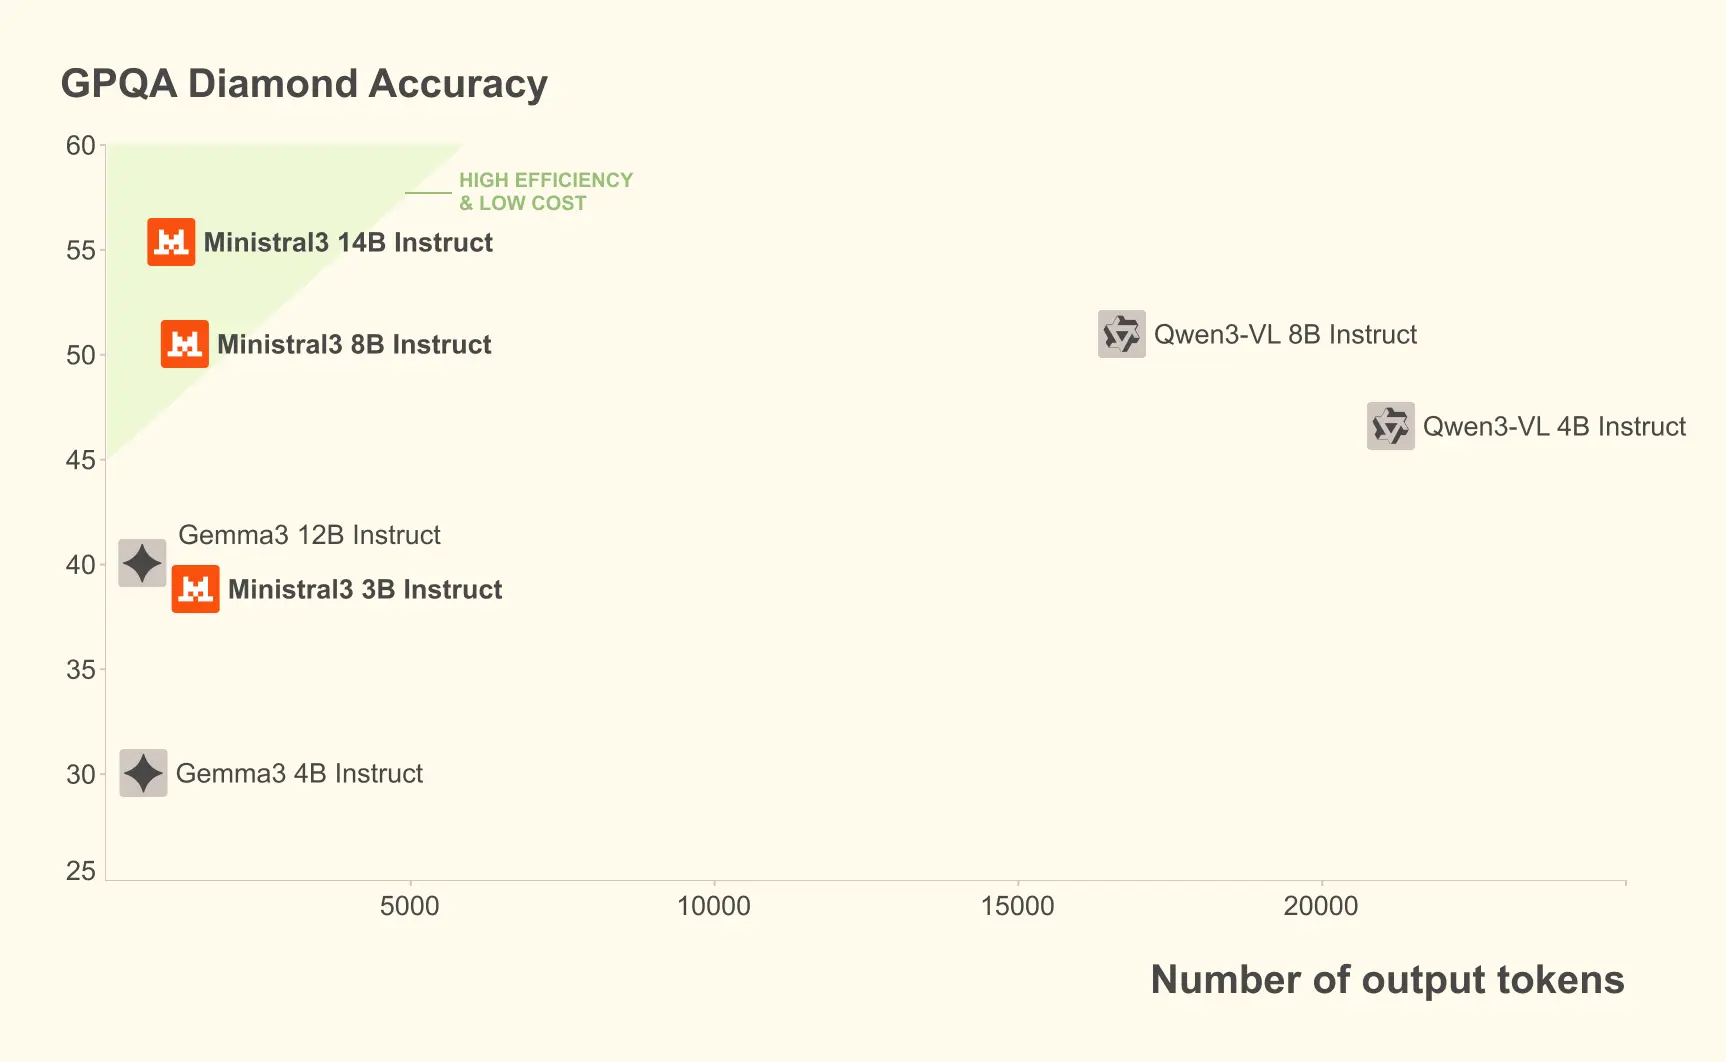
Sul dataset GPQA Diamond (un test rigoroso di ragionamento scientifico), varie varianti di Ministral 3 mantengono un’elevata accuratezza anche con un numero crescente di token di output. Ad esempio, il modello Ministral 3B Instruct mantiene un’accuratezza del 35-40% quando gestisce fino a 20,000 token, paragonabile a modelli più grandi come Gemma 2 9B, pur utilizzando meno risorse.
Qual è l’architettura di Mistral 3?
Mistral 3 è una famiglia più che una singola architettura, ma i due schemi architetturali da conoscere sono:
Modelli densi di piccole dimensioni (Ministral 3)
Stack Transformer standard, ottimizzati per efficienza e inferenza edge.
Offerti in più dimensioni (3B/8B/14B) e in diverse varianti finemente addestrate: base, instruct e reasoning; molte varianti includono supporto multimodale nativo (visione + testo) e funzionamento a contesto lungo. I modelli Ministral sono rilasciati con pesi FP8 ottimizzati per la compattezza in alcune distribuzioni.
Mixture-of-Experts sparso (Mistral Large 3)
Architettura MoE: il modello ha molti esperti (conteggio totale di parametri enorme), ma per ogni token viene valutato solo un sottoinsieme selezionato tramite routing — questo offre migliori compromessi scala/compute.
Mistral Large 3 dichiara ~675B parametri totali con ~41B parametri attivi durante l’inferenza, riflettendo il design MoE. Il modello è stato addestrato su hardware NVIDIA moderno e ottimizzato per un’esecuzione efficiente a bassa precisione (NVFP4/TensorRT/ottimizzazioni large-kernel).
Caratteristiche tecniche importanti per l’esecuzione locale:
Contesto lungo: alcune varianti di Mistral 3 supportano contesti molto lunghi (la documentazione di vLLM e Mistral menziona finestre di contesto enormi per certe varianti; ad es., 256k in alcune varianti Ministral). Questo influisce su memoria e pattern di serving.
Formati di pesi e quantizzazione: Mistral fornisce pesi in formati compressi/ottimizzati (FP8, NVFP4) e funziona con moderne toolchain di quantizzazione (BitsAndBytes, GPTQ, toolchain dei vendor) per un’inferenza locale pratica.
Perché dovresti eseguire Mistral 3 in locale?
Eseguire LLM in locale non è più un hobby di nicchia — è un’opzione pratica per team e individui che tengono a:
Riservatezza dei dati e conformità. L’hosting locale mantiene gli input sensibili all’interno della tua infrastruttura (importante per finanza, sanità, legale). Reuters ha riferito di clienti di alto profilo che scelgono di auto-ospitare i modelli Mistral.
Latenza e controllo dei costi. Per SLO di latenza stringenti e costi prevedibili, l’inferenza su cluster locali o privati può superare i costi imprevedibili delle API cloud. Le varianti Ministral più piccole e i formati quantizzati lo rendono praticabile.
Personalizzazione e fine-tuning. Quando serve un comportamento su misura, chiamate di funzione o nuove modalità, il controllo locale consente fine-tuning personalizzato e gestione dei dati. L’integrazione con Hugging Face e vLLM rende il tutto più immediato.
Se queste ragioni si allineano con le tue priorità — privacy, controllo, prevedibilità dei costi o ricerca — vale la pena considerare il deployment locale.
Come puoi eseguire Mistral 3 in locale (tre metodi pratici)?
Ci sono molti modi per eseguire Mistral 3 in locale. Coprirò tre approcci che coprono gli scenari più comuni:
Ollama (desktop/server locale senza configurazione, il più semplice per molti)
llama.cpp / ggml / inferenza CPU quantizzata GGUF (leggero, su laptop/CPU)
Per ciascun metodo indicherò quando ha senso, i prerequisiti, i comandi passo-passo e piccoli esempi di codice.
1) Come eseguire Mistral 3 con Ollama (il percorso più rapido)?
Quando usarlo: vuoi un’esperienza locale senza attriti (macOS/Linux/Windows), una CLI o GUI accessibile, e download/artefatti quantizzati automatici quando disponibili. Ollama ha voci di modelli per Ministral 3 e altri membri della famiglia Mistral.
Prerequisiti
Ollama installato (segui l’installer su ollama.com). La libreria Ollama indica versioni minime specifiche per alcuni rilasci di Ministral.
Spazio su disco sufficiente per memorizzare gli artefatti del modello (le dimensioni variano — le versioni quantizzate di Ministral 3B possono essere pochi GB; le varianti BF16 più grandi sono decine di GB).
Passaggi (esempio)
Installa Ollama (esempio macOS — sostituisci in base alla piattaforma):
# macOS (Homebrew) example — see ollama.com for platform-specific installersbrew install ollama
Esegui un modello Ministral:
# Pull and run the model interactivelyollama run ministral-3
Servi localmente (API) e chiamalo dal codice:
# Run Ollama server (default port shown in docs)ollama serve# Then curl against it (example)curl -s -X POST "http://localhost:11434/api/v1/generate" \ -H "Content-Type: application/json" \ -d '{"model":"ministral-3","prompt":"Summarize Mistral 3 in one sentence."}'
Note e suggerimenti
Ollama gestisce il download del modello e (quando disponibili) varianti quantizzate in locale — molto comodo per provare rapidamente i modelli.
Se prevedi di usare il modello in produzione con molte richieste concorrenti, Ollama è ottimo per il prototipo, ma valuta scalabilità e orchestrazione delle risorse per carichi costanti.
2) Come eseguire Mistral 3 con Hugging Face Transformers (GPU / integrazione vLLM)?
Quando usarlo: ti serve controllo programmatico per ricerca o produzione, vuoi fare fine-tuning o usare stack di inferenza accelerati come vLLM su cluster GPU. Hugging Face fornisce supporto Transformers e Mistral offre checkpoint ottimizzati per vLLM/NVIDIA.
Prerequisiti
GPU con memoria sufficiente (varia per modello e precisione). I modelli Ministral piccoli (3B/8B) possono girare su una singola GPU di fascia media quando quantizzati; varianti più grandi richiedono più H100/A100 o checkpoint NVFP4 ottimizzati per vLLM. La documentazione NVIDIA e Mistral raccomanda dimensioni di nodo specifiche per i modelli large.
Python, PyTorch, transformers, accelerate (o vLLM se vuoi quel server).
Esempio Python — pipeline Hugging Face di base (variante 3B instruct, GPU):
# Example: CPU/GPU inference with transformers pipeline# Assumes you have CUDA and a compatible PyTorch build.import torchfrom transformers import pipelinemodel_name = "mistralai/Ministral-3-3B-Instruct-2512-BF16" # example HF model idgenerator = pipeline( "text-generation", model=model_name, device_map="auto", torch_dtype=torch.bfloat16, # use bfloat16 if your hardware supports it)prompt = "Explain how attention helps transformers, in 3 sentences."out = generator(prompt, max_new_tokens=120, do_sample=False)print(out[0]["generated_text"])
Utilizzare vLLM per l’inferenza GPU in produzione
vLLM è progettato per servire modelli grandi in modo efficiente, supporta la famiglia Mistral 3 e Mistral ha pubblicato checkpoint ottimizzati per hardware vLLM/NVIDIA (NVFP4/FP8) per ridurre l’impronta di memoria e aumentare la velocità. Avviare un server vLLM ti fornisce un endpoint di inferenza batched e a bassa latenza. Vedi le ricette vLLM e le indicazioni Mistral per i percorsi dei modelli e i flag raccomandati.
Note e suggerimenti
Per la produzione, preferisci checkpoint ottimizzati (NVFP4/FP8) ed esegui su GPU raccomandate (ad es., H100/A100) o usa un livello di orchestrazione che supporti parallelismo di tensori/modelli. Mistral e NVIDIA hanno documentazione e post sul blog su runtime ottimizzati.
Fissa sempre l’esatto checkpoint del modello su disco (o uno snapshot HF riproducibile) per risultati ripetibili e per evitare aggiornamenti silenziosi del modello.
3) Come eseguire Mistral 3 su CPU con llama.cpp / modelli GGUF quantizzati?
Quando usarlo: ti serve inferenza locale e offline su CPU (ad es., laptop da sviluppatore, ambiente isolato) e accetti di scambiare un po’ di accuratezza con efficienza di runtime e memoria. Questo metodo usa ggml/llama.cpp e pesi GGUF quantizzati (q4/q5/etc.).
Prerequisiti
Una build GGUF quantizzata di un modello Ministral (molti membri della community pubblicano GGUF quantizzati su Hugging Face o convertono pesi BF16 in GGUF in locale). Cerca varianti GGUF di Ministral-3-3B-Instruct.
Binario compilato di llama.cpp (segui il README del progetto).
Quantizzare (se hai i pesi originali) — esempio (concettuale)
# Example: quantize from an FP16/BF16 model to a GGUF q4_K_M (syntax depends on llama.cpp version)./quantize /path/to/original/model.bin /path/to/out.gguf q4_k_m
Eseguire un GGUF con llama.cpp
# run interactive inference with a quantized GGUF model./main -m /path/to/ministral-3-3b-instruct.gguf -t 8 -c 2048 --interactive# -t sets threads, -c sets context (tokens) if supported
Esempio client Python (server locale llama.cpp o subprocess)
Puoi avviare llama.cpp come subprocess e alimentarlo con prompt, o usare un piccolo client wrapper. Molti progetti della community offrono un semplice server HTTP wrapper intorno a llama.cpp per l’integrazione con app locali.
Note e compromessi
La quantizzazione riduce la VRAM e abilita l’inferenza su CPU ma può ridurre la qualità (da lieve a moderata, a seconda del formato). Formati come q4_K_M o varianti q5 sono compromessi comuni per l’uso su CPU. Post giapponesi e tecnici spiegano in dettaglio i tipi Q4/Q5 e le conversioni GGUF.
Per carichi piccoli o medi, GGUF + llama.cpp è spesso il modo più economico e portabile per eseguire LLM in locale.
Quali considerazioni hardware e di memoria contano?
Indicazioni pratiche e concise:
Modelli 3B: spesso possono essere quantizzati ed eseguiti su una buona CPU da laptop o su una singola GPU con 8–16 GB di VRAM (a seconda di precisione/quantizzazione). Le varianti GGUF q4 possono girare su molte CPU moderne.
Ministral 8B e 14B: in genere richiedono una GPU di fascia media (ad es., 24–80 GB a seconda di precisione e caching delle attivazioni) o quantizzazione su più dispositivi.
Mistral Large 3 (675B totali, 41B attivi): pensato per il deployment in data center e in genere funziona al meglio con nodi multi-GPU (ad es., 8×A100 o H100) e formati specializzati (NVFP4/FP8) per vLLM. Mistral ha esplicitamente pubblicato checkpoint ottimizzati per rendere più praticabili tali deployment.
Se la tua priorità è l’uso su laptop in locale, punta alla via Ministral 3B quantizzato GGUF + llama.cpp. Se la tua priorità è la throughput in produzione, guarda vLLM + checkpoint NVFP4 su GPU. Se vuoi la facilità di sperimentazione, Ollama è il modo più rapido per iniziare.
Come scegliere quantizzazione e precisione?
La quantizzazione è un compromesso: memoria e velocità vs. qualità grezza del modello. Scelte comuni:
q4_0 / q4_1 / q4_K_M: opzioni a 4 bit popolari per l’inferenza su CPU; q4_K_M (variante k-means) spesso offre un buon equilibrio qualità/prestazioni.
varianti q5 / q8 / imatrix: formati intermedi che possono preservare più fedeltà a costo di dimensioni maggiori.
FP16 / BF16 / FP8 / NVFP4: precisioni su GPU — BF16 e FP16 sono comuni per training/inferenza su GPU moderne; FP8 / NVFP4 sono formati emergenti che risparmiano memoria per modelli molto grandi e sono supportati da runtime ottimizzati e dai rilasci di checkpoint di Mistral.
Regola pratica: per esecuzioni locali su CPU scegli q4_K_M o simili; per inferenza su GPU con alta fedeltà usa BF16/FP16 o FP8/NVFP4 specifici del vendor quando supportati dal runtime.
Conclusione — dovresti eseguire Mistral 3 in locale?
Se ti servono privacy, bassa latenza o personalizzazione, sì: la famiglia Mistral 3 offre un ampio ventaglio — modelli piccoli per CPU edge, modelli medi per una singola GPU o cluster modesti, e una variante MoE grande per la scala da data center — e l’ecosistema (Ollama, Hugging Face, vLLM, llama.cpp) supporta già pattern pratici di deployment locale e privato. Mistral ha inoltre lavorato con NVIDIA e vLLM per fornire checkpoint ottimizzati ad alta throughput e ridotta impronta di memoria, rendendo l’auto-hosting in produzione più realistico di prima.
Per iniziare, esplora le capacità di altri modelli (come Gemini 3 Pro) nel Playground e consulta la guida API per istruzioni dettagliate. Prima dell’accesso, assicurati di aver effettuato l’accesso a CometAPI e di aver ottenuto la chiave API. CometAPI offre un prezzo molto inferiore a quello ufficiale per aiutarti a integrare.