Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
Mistral 3 es el lanzamiento destacado de la familia de modelos de Mistral AI de finales de 2025. Aporta una combinación de modelos compactos y rápidos orientados al despliegue local/en el edge y un buque insignia disperso muy grande que lleva al estado del arte en escala y longitud de contexto. Este artículo explica qué es Mistral 3, cómo está construido, por qué podrías querer ejecutarlo en local y tres formas prácticas de ejecutarlo en tu máquina o servidor privado — desde la comodidad “click-to-run” de Ollama hasta el servicio de GPU de producción con vLLM/TGI, pasando por la inferencia en CPU para dispositivos muy pequeños usando GGUF + llama.cpp.
¿Qué es Mistral 3?
Mistral 3 es la última generación de modelos de pesos abiertos de Mistral AI. La familia incluye tanto un Mistral Large 3 masivo (un modelo disperso de mezcla de expertos — MoE) como varias variantes para edge/“Ministral” (3B, 8B, 14B) ajustadas para seguimiento de instrucciones y tareas multimodales (texto+visión). Mistral posicionó el lanzamiento para que sea ampliamente utilizable: desde inferencia de alto rendimiento en centros de datos (con checkpoints optimizados especializados) hasta uso en el edge y portátiles mediante formatos cuantizados y variantes más pequeñas.
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
Propiedades prácticas clave:
Una arquitectura de mezcla de expertos (MoE) en la variante Large 3 que proporciona un recuento de parámetros “total” muy grande activando solo un subconjunto de expertos por token — esto mejora la eficiencia a escala.
Una familia de modelos Ministral 3 (3B / 8B / 14B) orientados al edge y uso local, con variantes instruction-tuned y multimodales.
Checkpoints oficiales y un conjunto de checkpoints optimizados (NVFP4/FP8) para runtimes acelerados como vLLM y plataformas NVIDIA.
Multimodal + multilingüe + contexto largo — las variantes Ministral y Large enfatizan la comprensión de imagen+texto y una amplia cobertura de idiomas. Para aplicaciones que combinan imágenes + documentos largos, esto importa.
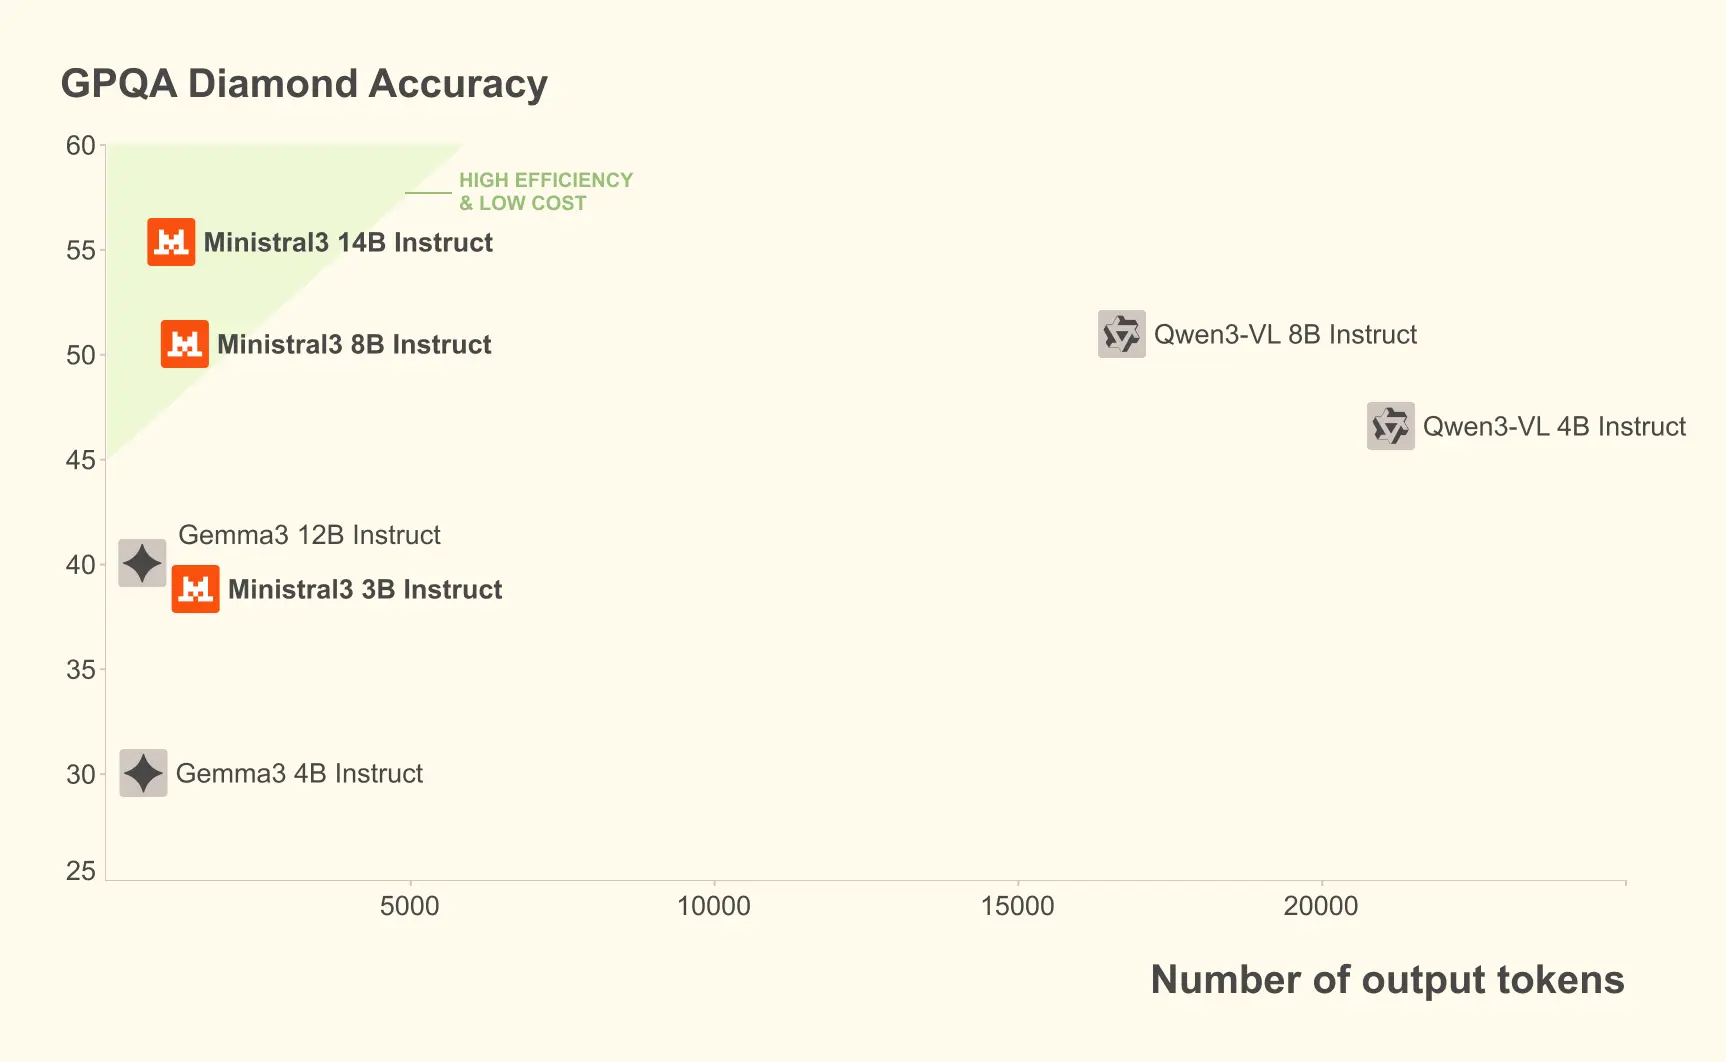
En el dataset GPQA Diamond (una prueba rigurosa de razonamiento científico), varias variantes de Ministral 3 mantienen alta precisión incluso con números crecientes de tokens de salida. Por ejemplo, el modelo Ministral 3B Instruct mantiene un 35-40% de precisión al manejar hasta 20.000 tokens, comparable a modelos más grandes como Gemma 2 9B, usando menos recursos.
¿Cuál es la arquitectura de Mistral 3?
Mistral 3 es una familia más que una arquitectura única, pero los dos patrones arquitectónicos que debes entender son:
Modelos pequeños densos (Ministral 3)
Pilas Transformer estándar, optimizadas para eficiencia e inferencia en el edge.
Ofrecidos en múltiples tamaños (3B/8B/14B) y en diferentes variantes afinadas: base, instruct y reasoning; muchas variantes incluyen soporte multimodal (visión + texto) nativo y operación de contexto largo. Los modelos Ministral se publican con pesos FP8 optimizados para compacidad en algunas distribuciones.
Mezcla de expertos dispersa (Mistral Large 3)
Arquitectura MoE: el modelo tiene muchos expertos (recuento total de parámetros enorme), pero solo se evalúa un subconjunto seleccionado por el enrutamiento por token — lo que ofrece mejores compromisos de escala vs. cómputo.
Mistral Large 3 cita ~675B parámetros totales con ~41B parámetros activos durante la inferencia, reflejando este diseño MoE. El modelo se entrenó en hardware NVIDIA moderno y se optimizó para ejecución eficiente en baja precisión (NVFP4/TensorRT/optimizaciones de kernels grandes).
Características técnicas que importan al ejecutarlo en local:
Contexto largo: algunas variantes de Mistral 3 soportan contextos muy largos (la documentación de vLLM y Mistral menciona ventanas de contexto masivas para ciertas variantes; p. ej., 256k en algunas variantes de Ministral). Eso afecta patrones de memoria y servicio.
Formatos de pesos y cuantización: Mistral proporciona pesos en formatos comprimidos/optimizados (FP8, NVFP4) y funciona con toolchains de cuantización modernas (BitsAndBytes, GPTQ, toolchains de proveedores) para inferencia práctica en local.
¿Por qué querrías ejecutar Mistral 3 en local?
Ejecutar LLMs en local ya no es un hobby de nicho — es una opción práctica para equipos e individuos que se preocupan por:
Privacidad de datos y cumplimiento. El hosting local mantiene las entradas sensibles dentro de tu infraestructura (importante para finanzas, salud, legal). Reuters informó de clientes de alto perfil que eligen alojar por sí mismos modelos de Mistral.
Latencia y control de costes. Para SLOs de latencia estrictos y costes predecibles, la inferencia local o en clúster privado puede superar la factura de APIs en la nube. Las variantes Ministral más pequeñas y los formatos cuantizados lo hacen práctico.
Personalización y fine-tuning. Cuando necesitas comportamiento a medida, function calling o nuevas modalidades, el control local permite fine-tuning y manejo de datos personalizados. La integración con Hugging Face y vLLM lo hace más directo.
Si esas razones se alinean con tus prioridades — privacidad, control, previsibilidad de costes o investigación — el despliegue local merece la pena.
¿Cómo puedes ejecutar Mistral 3 en local (tres métodos prácticos)?
Hay muchas formas de ejecutar Mistral 3 en local. Cubriré tres enfoques que abarcan los escenarios de usuario más comunes:
Ollama (escritorio/servidor local sin configuración, lo más fácil para muchos usuarios)
llama.cpp / ggml / inferencia en CPU cuantizada GGUF (ligero, funciona en portátiles/CPU)
Para cada método listaré cuándo tiene sentido, los prerrequisitos, comandos paso a paso y pequeños ejemplos de código.
1) ¿Cómo ejecutar Mistral 3 con Ollama (ruta más rápida)?
Cuándo usar esto: quieres una experiencia local sin fricciones (macOS/Linux/Windows), una CLI o GUI accesible, y descargas/artifacts cuantizados automáticos cuando estén disponibles. Ollama tiene entradas de modelos para Ministral 3 y otros miembros de la familia Mistral.
Prerrequisitos
Ollama instalado (sigue el instalador en ollama.com). La librería de Ollama indica versiones mínimas específicas para algunos lanzamientos de Ministral.
Suficiente espacio en disco para almacenar los artifacts del modelo (los tamaños difieren — las versiones cuantizadas de Ministral 3B pueden ser de unos pocos GB; las variantes BF16 más grandes ocupan muchas decenas de GB).
Pasos (ejemplo)
Instala Ollama (ejemplo macOS — ajusta según plataforma):
# macOS (Homebrew) example — see ollama.com for platform-specific installersbrew install ollama
Ejecuta un modelo Ministral:
# Pull and run the model interactivelyollama run ministral-3
Sirve en local (API) y llámalo desde código:
# Run Ollama server (default port shown in docs)ollama serve# Then curl against it (example)curl -s -X POST "http://localhost:11434/api/v1/generate" \ -H "Content-Type: application/json" \ -d '{"model":"ministral-3","prompt":"Summarize Mistral 3 in one sentence."}'
Notas y consejos
Ollama gestiona la descarga del modelo y (cuando están disponibles) variantes cuantizadas locales — muy conveniente para probar modelos rápidamente.
Si planeas usar el modelo en producción con muchas solicitudes concurrentes, Ollama es excelente para prototipado, pero evalúa la escalabilidad y orquestación de recursos para carga sostenida.
2) ¿Cómo ejecutar Mistral 3 con Hugging Face Transformers (GPU / integración con vLLM)?
Cuándo usar esto: necesitas control programático para investigación o producción, quieres hacer fine-tuning o usar stacks de inferencia acelerados como vLLM en clústeres GPU. Hugging Face proporciona soporte en Transformers y Mistral ofrece checkpoints optimizados para vLLM/NVIDIA.
Prerrequisitos
GPU con memoria suficiente (varía según el modelo y la precisión). Los Ministral 3 pequeños (3B/8B) pueden ejecutarse en una sola GPU de gama media cuando se cuantizan; las variantes más grandes requieren múltiples H100/A100 o checkpoints NVFP4 optimizados para vLLM. La documentación de NVIDIA y Mistral recomienda tamaños de nodo específicos para los modelos grandes.
Python, PyTorch, transformers, accelerate (o vLLM si quieres ese servidor).
Ejemplo en Python — pipeline básico de Hugging Face (variante 3B instruct, GPU):
# Example: CPU/GPU inference with transformers pipeline# Assumes you have CUDA and a compatible PyTorch build.import torchfrom transformers import pipelinemodel_name = "mistralai/Ministral-3-3B-Instruct-2512-BF16" # example HF model idgenerator = pipeline( "text-generation", model=model_name, device_map="auto", torch_dtype=torch.bfloat16, # use bfloat16 if your hardware supports it)prompt = "Explain how attention helps transformers, in 3 sentences."out = generator(prompt, max_new_tokens=120, do_sample=False)print(out[0]["generated_text"])
Uso de vLLM para inferencia en GPU de producción
vLLM está diseñado para servir modelos grandes de manera eficiente, admite la familia Mistral 3, y Mistral publicó checkpoints optimizados para hardware vLLM/NVIDIA (NVFP4/FP8) para reducir la huella de memoria y acelerar. Iniciar un servidor vLLM te da un endpoint de inferencia con baja latencia y batching. Consulta las recetas de vLLM y la guía de Mistral para las rutas de los modelos y flags recomendados.
Notas y consejos
Para producción, prefiere checkpoints optimizados (NVFP4/FP8) y ejecuta en GPUs recomendadas (p. ej., H100/A100) o usa una capa de orquestación que admita paralelismo de tensores/modelos. Mistral y NVIDIA tienen documentación y entradas de blog sobre runtimes optimizados.
Fija siempre el checkpoint de modelo exacto en disco (o un snapshot reproducible de HF) para resultados reproducibles y para evitar actualizaciones silenciosas del modelo.
3) ¿Cómo ejecutar Mistral 3 en CPU con llama.cpp / modelos GGUF cuantizados?
Cuándo usar esto: necesitas inferencia local y offline en CPU (p. ej., portátil de desarrollador, entorno seguro aislado) y estás dispuesto a sacrificar algo de calidad por eficiencia de ejecución y memoria. Este método usa ggml/llama.cpp y pesos GGUF cuantizados (q4/q5/etc.).
Prerrequisitos
Un build GGUF cuantizado de un modelo Ministral (muchos miembros de la comunidad publican GGUFs cuantizados en Hugging Face o convierten pesos BF16 a GGUF localmente). Busca variantes GGUF de Ministral-3-3B-Instruct.
Binario de llama.cpp compilado (sigue el README del proyecto).
Cuantizar (si tienes los pesos originales) — ejemplo (conceptual)
# Example: quantize from an FP16/BF16 model to a GGUF q4_K_M (syntax depends on llama.cpp version)./quantize /path/to/original/model.bin /path/to/out.gguf q4_k_m
Ejecutar un GGUF con llama.cpp
# run interactive inference with a quantized GGUF model./main -m /path/to/ministral-3-3b-instruct.gguf -t 8 -c 2048 --interactive# -t sets threads, -c sets context (tokens) if supported
Ejemplo de cliente en Python (servidor local de llama.cpp o subproceso)
Puedes lanzar llama.cpp como un subproceso y alimentarle prompts, o usar un pequeño cliente wrapper. Muchos proyectos de la comunidad ofrecen un servidor HTTP sencillo alrededor de llama.cpp para integración en apps locales.
Notas y compromisos
La cuantización reduce VRAM y permite inferencia en CPU pero puede disminuir la calidad (de leve a moderada, según el formato). Formatos como q4_K_M o variantes q5 son compromisos habituales para uso en CPU. Publicaciones técnicas (incluidas en japonés) explican los tipos Q4/Q5 y conversiones a GGUF en detalle.
Para cargas pequeñas y medianas, GGUF + llama.cpp suele ser la forma más barata y portátil de ejecutar LLMs en local.
¿Qué consideraciones de hardware y memoria importan?
Guía corta y práctica:
Modelos 3B: a menudo pueden cuantizarse y ejecutarse en la CPU de un portátil decente o en una sola GPU con 8–16 GB de VRAM (según precisión/cuantización). Las variantes GGUF q4 pueden ejecutarse en muchas CPUs modernas.
Ministral 8B y 14B: normalmente requieren una GPU de gama media (p. ej., 24–80 GB según la precisión y el caché de activaciones) o cuantización a través de múltiples dispositivos.
Mistral Large 3 (675B total, 41B activos): pensado para despliegue en centros de datos y, en general, funciona mejor con nodos multi-GPU (p. ej., 8×A100 o H100) y formatos especializados (NVFP4/FP8) para vLLM. Mistral publicó checkpoints optimizados explícitamente para hacer viables estos despliegues.
Si tu prioridad es uso en portátil en local, apunta a la ruta Ministral 3B cuantizado GGUF + llama.cpp. Si tu prioridad es rendimiento en producción, mira vLLM + checkpoints NVFP4 en GPUs. Si quieres facilidad de experimentación, Ollama es la forma más rápida de empezar.
¿Cómo deberías elegir cuantización y precisión?
La cuantización es un compromiso: memoria y velocidad vs. calidad bruta del modelo. Elecciones comunes:
q4_0 / q4_1 / q4_K_M: opciones populares de 4 bits usadas para inferencia en CPU; q4_K_M (variante k-means) suele ofrecer un mejor equilibrio calidad/rendimiento.
Variantes q5 / q8 / imatrix: formatos intermedios que pueden preservar más fidelidad a costa de tamaño.
FP16 / BF16 / FP8 / NVFP4: precisiones de GPU — BF16 y FP16 son comunes para entrenamiento/inferencia en GPUs modernas; FP8 / NVFP4 son formatos emergentes que ahorran memoria para modelos muy grandes y están soportados por runtimes optimizados y publicaciones de checkpoints de Mistral.
Regla general: para ejecuciones en CPU en local, elige q4_K_M o similar; para inferencia en GPU con alta fidelidad, usa BF16/FP16 o FP8/NVFP4 específicos del proveedor cuando el runtime los soporte.
Conclusión — ¿deberías ejecutar Mistral 3 en local?
Si necesitas privacidad, baja latencia o personalización, sí: la familia Mistral 3 te ofrece una amplia paleta — modelos diminutos para CPU en el edge, modelos medianos para una sola GPU o clúster modesto, y un sabor MoE grande para escala de centro de datos — y el ecosistema (Ollama, Hugging Face, vLLM, llama.cpp) ya admite patrones prácticos de despliegue local y privado. Mistral también trabajó con NVIDIA y vLLM para proporcionar checkpoints optimizados para alto rendimiento y menor huella de memoria, lo que hace que el autoalojamiento en producción sea más realista que antes.
Para empezar, explora más capacidades de modelos (como Gemini 3 Pro) en el Playground y consulta la guía de la API para instrucciones detalladas. Antes de acceder, asegúrate de haber iniciado sesión en CometAPI y obtenido la clave de API. CometAPI ofrece un precio muy inferior al oficial para ayudarte a integrarte.